
第二篇:Palantir 的本体论赌注——哪些可迁移,哪些不可复制
法思科技圈|2026.9 | AI 技术深度分析
中国至少有十几家公司声称"对标 Palantir"。但如果我们诚实追问:有谁真正在自己的产品里建立了一套 Ontology 驱动架构?答案接近于零。这不是执行力问题——是路径本身存在根本性的"环境依赖"。
一、重读 Palantir:不是一家公司,是一份 20 年的实验报告
Palantir 的故事通常被当作一家公司的成功史来讲。但如果我们换一个视角——把它看作一份关于"本体论驱动企业软件"的持续 20 年的实验报告——它的价值就完全不同了。
这份实验回答了三个根本问题:Ontology 能否成为企业软件的统一抽象层?能。Palantir 证明了不同行业的业务实体都可以被建模到同一套 Ontology 框架中。Ontology 的构建是否能形成飞轮效应?能。每新增一个客户的 Ontology 构建,都会沉淀出可复用的模型组件,使得下一个客户的构建成本递减。这是 Palantir 毛利率长期维持 80%+ 的底层原因。Ontology 能否承载 AI?能,而且可能是唯一可靠的承载方式。2023 年推出 AIP 时,大模型通过 Ontology 层来理解企业——Ontology 成了 AI 的"企业级操作系统"。
二、Palantir 的架构本质:三层翻译器
抛开产品线的名称,Palantir 的技术架构本质上是一套 三层翻译器,把整个企业的业务逻辑变成了可编程的语义操作系统。
第一层:语义翻译器(Data → Meaning)。原始数据以各种形态散落在 SAP、Salesforce、CRM 中。语义层做的事是把这些异构数据翻译为统一的业务语义网络。关键设计:不搬运数据,只建立映射——Ontology 不是另一个数据仓库,而是一个数据之上的语义索引。
第二层:动力翻译器(Meaning → Action)。当业务语义被建模后,动力层把这些语义翻译为可执行的操作。这不是传统的 if-else 规则引擎,而是附着在语义网络上的自动化层。
第三层:演化翻译器(Action → Evolution)。这是最容易被忽略但最重要的一层。Palantir 的 FDE(前线部署工程师)机制本质上是一个持续反馈翻译器——把每个客户现场的定制需求翻译为平台通用能力的增量。三层翻译器合在一起,形成的是一个自演化的企业语义操作系统。
三、FDE 机制:本体论构建的"人肉编译器"
Palantir 最反常识的机制是 FDE——派最顶尖的工程师去客户现场驻场,以年为单位,单个项目的利润率可能极其难看。但 FDE 不是在"做项目",而是在训练 Ontology 编译器:每服务一个航空公司,"航班"对象的能力就更精细;每服务一个药企,"临床试验"对象的建模就更成熟。
这种模式的残酷之处在于:前 100 个项目的投入产出比是负的。只有当 Ontology 积累到一定程度,边际成本才开始断崖式下降。Palantir 从 2003 年成立到 2022 年 Q4 实现首次季度盈利——这 20 年的亏损本质上是 Ontology 的构建期。
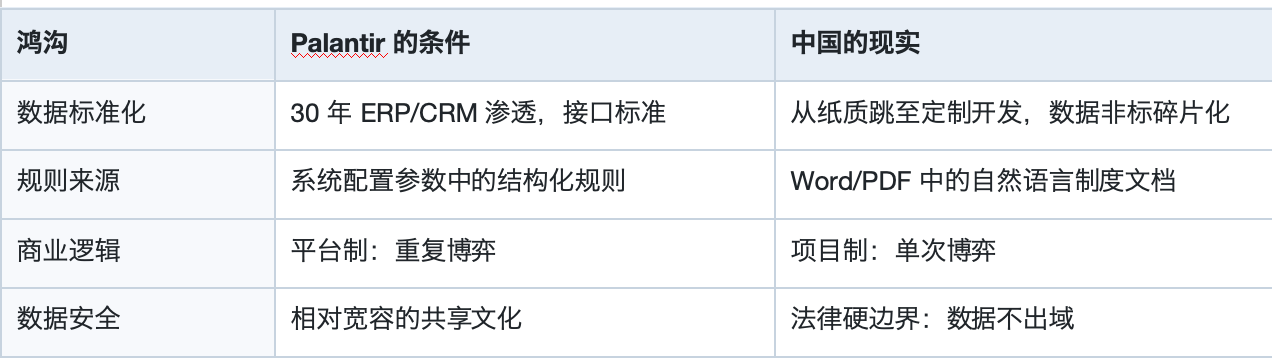
四、为什么中国不能照搬:四层结构性鸿沟
Palantir 的实验结论虽然是成立的,但实验的条件在中国几乎全部不成立。
五、可迁移的是什么:三条核心原则
虽然环境不可复制,但 Palantir 实验揭示的原则是可迁移的。
原则一:Ontology 第一,不是 Agent 第一。 Palantir 推出 AIP 时 Ontology 已经构建了 20 年。AIP 的成功不是因为大模型技术好,而是因为大模型接入了一个已经成熟的语义层。
原则二:Ontology 的核心是关系,不是数据。 Palantir 不是"把数据集中管理",而是"管理数据之间的关系"。不是先建数据中台再建 Ontology,而是把 Ontology 建在现有数据之上——不做数据搬迁,只做语义建模。
原则三:Ontology 的构建成本需要摊销机制。 无论 FDE 还是其他机制,本质上都是 Ontology 的重度前期投入需要换取后期复用收益的商业设计。Ontology 是重资产,投资回报周期以年为单位计算。
六、中国路径的约束条件
综合以上分析,中国企业的 Ontology 建设面临一组独特的约束条件:
· 数据约束:源数据是非标、碎片化的,Ontology 不能假设已有标准接口
· 规则约束:合规规则以自然语言文档形式存在,需要编译而非直接映射
· 安全约束:原始数据不能出域,Ontology 的构建必须在本地完成
· 规模约束:客户包括大量中小企业,Ontology 不能只服务头部
这些约束定义了中国企业 Ontology 的环境方程。Palantir 给了答案的结构,但方程的求解需要完全不同的路径。
— 法思科技圈|2026.9 —